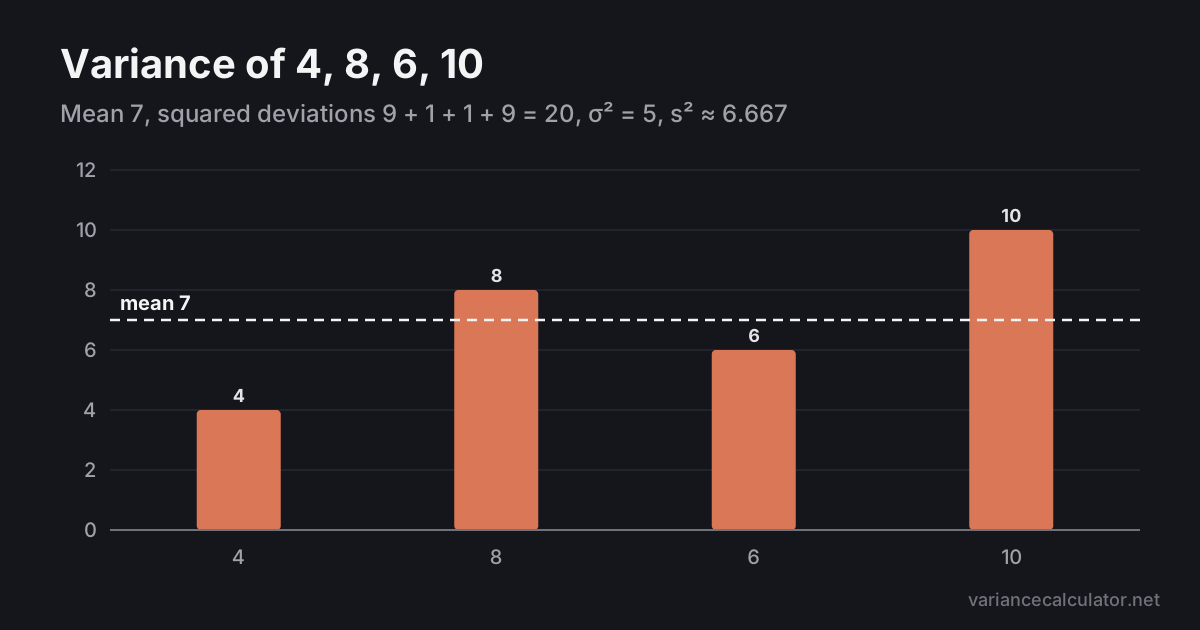
 Statistics
How Do You Calculate Variance? A Simple Explanation With Real Examples
How to calculate variance step by step: find the mean, the deviations, the squared deviations and the sum of squares, with a fully worked example.
डेटा इनपुट
परिणाम देखने के लिए डेटा मान दर्ज करें
Variance tells you how spread out a set of numbers is: how far, on average, the values sit from their mean once each distance is squared. This calculator takes a list of numbers and works that out for you. It finds the mean, subtracts it from every value, squares the differences, adds them up and divides, then shows each of those steps so you can follow or check the working.
It is written for students checking homework, teachers preparing examples, and anyone who needs a quick, reliable figure for a report or a spreadsheet. You get both versions of the answer: sample variance (s²), which divides by n − 1 and is the one to use when your numbers are a sample from a larger group, and population variance (σ²), which divides by n and is for when you have every value in the group. The standard deviation, mean, range and sum of squares come with it.
To use it, type or paste your numbers into the box above, separated by commas, spaces or new lines. You can paste a column straight from Excel or Google Sheets. Choose Sample or Population, and the results and chart update as you type. Everything is calculated in your browser, so your data is not uploaded anywhere.
विचरण गणना के पीछे के गणित को समझें।
इंटरैक्टिव: यह देखने के लिए कि यह क्या दर्शाता है, सूत्र में किसी भी प्रतीक पर होवर करें या टैप करें।
नमूना डेटा से निष्पक्ष विचरण अनुमान के लिए n - 1 (बेसेल क�� सुधार) का उपयोग करता है। यह समायोजन स्वतंत्रता की डिग्री के लिए जिम्मेदार है जब वास्तविक जनसंख्या माध्य अज्ञात है।
सीधेनसे विभाजित होता है। किसी सुधार की आवश्यकता नहीं है क्योंकि जनसंख्या माध्य (μ) पूरी जनसंख्या का वास्तविक माध्य है।
फॉर्मूला के माध्यम से डेटा कैसे प्रवाहित होता है
जनसंख्या भिन्नता और नमूना भिन्नता एक ही स्थान पर भिन्न होती है: विभाजक। जनसंख्या भिन्नता वर्ग अंतर के योग को n (कुल गणना) से विभाजित करती है। नमूना विचरण को n - 1 से विभाजित किया जाता है - बेसेल का सुधार - नमूना डेटा से एक निष्पक्ष विचरण अनुमान उत्पन्न करने के लिए। यह सुधार छोटे नमूनों के साथ सबसे अधिक मायने रखता है। बड़े डेटासेट के लिए, अंतर कम हो जाता है।
वेरिएंस मापता है कि डेटा सेट में प्रत्येक संख्या माध्य से कितनी दूर है। ये विचरण गणना चरण हैं।
विचरण की गणना करने के लिए, माध्य से वर्ग अंतर का औसत ज्ञात करें। जनसंख्या भिन्नता और नमूना भिन्नता के लिए प्रक्रिया समान है - एकमात्र अंतर यह है कि आप अंत में n या n - 1 से विभाजित करते हैं या नहीं। यह सांख्यिकीय विचरण गणना सर्वेक्षण विश्लेषण से लेकर मशीन लर्निंग फीचर चयन तक, किसी भी डेटा सेट के लिए काम करती है।
इसे आज़माएँ: संख्याएँ दर्ज करें और प्रत्येक चरण देखें
अल्पविराम द्वारा अलग किए गए 3-8 नंबर टाइप करें। नीचे दिए गए चरण वास्तविक समय में आपके डेटा के साथ भिन्नता की गणना करेंगे।
माध्य ज्ञात करें (औसत)
डेटा सेट में सभी मान जोड़ें और गिनती से विभाजित करें। [4, 8, 6, 5, 3] के लिए, माध्य (4+8+6+5+3) ÷ 5 = 5.2 है। यह माध्य प्रत्येक विचरण गणना का केंद्र बिंदु है।
विचलन प्राप्त करने के लिए माध्य घटाएँ
प्रत्येक संख्या का विचलन ज्ञात करने के लिए उसमें से माध्य घटाएँ। नकारात्मक विचलन का मतलब है कि मान माध्य से नीचे है; सकारात्मक मान ऊपर हैं. विचलनों का योग सदैव 0 के बराबर होता है।
प्रत्येक विचलन का वर्ग करें
इसे सकारात्मक बनाने के लिए प्रत्येक विचलन का वर्ग करें। यह सुनिश्चित करता है कि माध्य से नीचे और ऊपर के विचलन एक दूसरे को रद्द नहीं करते हैं। वर्ग करने से आउटलेर्स को अधिक भार भी मिलता है।
वर्गाकार विचलनों का योग करें
सभी वर्ग विचलनों को एक साथ जोड़ें। इस योग को वर्गों का योग (एसएस) कहा जाता है। हमारे डेटा के लिए, यह 1.44 + 7.84 + 0.64 + 0.04 + 4.84 = 14.8 है।
भिन्नता पाने के लिए विभाजित करें
वर्गों के योग को N (जनसंख्या के लिए) या n - 1 (नमूने के लिए) से विभाजित करें। नमूना भिन्नता के लिए, हम 3.7 प्राप्त करने के लिए 14.8 को 4 से विभाजित करते हैं। जनसंख्या भिन्नता के लिए, हम 2.96 प्राप्त करने के लिए 5 से विभाजित करते हैं।
आइए एक नमूना डेटासेट के विचरण की गणना करें: 4, 8, 6, 5, 3, 7, 2, 9.
डेटा सेट पर विचार करें: 4, 8, 6, 5, 3, 7, 2, 9। हम इन 8 मानों के लिए नमूना भिन्नता (s²) और जनसंख्या भिन्नता (σ²) दोनों की गणना करेंगे। नीचे दिए गए बार चार्ट को देखें - जब आप प्रत्येक चरण में स्क्रॉल करते हैं तो यह प्रत्येक डेटा बिंदु, माध्य रेखा और वर्ग विचलन दिखाता है।
माध्य डेटा सेट का केंद्र है - प्रत्येक विचलन को इस बिंदु से मापा जाता है। उपरोक्त बार चार्ट में, धराशायी रेखा x̄ = 5.5 को चिह्नित करती है।
| xᵢ | विचलन (x − x̄) | वर्ग विचलन (x − x̄)² |
|---|---|---|
| 4 | −1.5 | 2.25 |
| 8 | 2.5 | 6.25 |
| 6 | 0.5 | 0.25 |
| 5 | −0.5 | 0.25 |
| 3 | −2.5 | 6.25 |
| 7 | 1.5 | 2.25 |
| 2 | −3.5 | 12.25 |
| 9 | 3.5 | 12.25 |
प्रत्येक पंक्ति एक डेटा बिंदु, माध्य से उसका विचलन और वर्ग विचलन दिखाती है। ध्यान दें कि कैसे x̄ (जैसे 2 और 9) से दूर के मान बहुत बड़े वर्ग अंतर उत्पन्न करते हैं।
वर्गों का यह योग (42) माध्य से सभी डेटा बिंदुओं की कुल वर्ग दूरी को दर्शाता है। यह दोनों भिन्न सूत्रों में अंश है।
कैलकुलेटर के बिना मैन्युअल रूप से भिन्नता की गणना करने के लिए इन चेकलिस्ट चरणों का पालन करें।
सभी नंबरों को स्पष्ट रूप से सूचीबद्ध करें। गिनें कि आपके पास कितने मान हैं (एन)।
सभी संख्याओं को जोड़ें और n से भाग दें। इस मान पर ध्यान दें.
प्रत्येक कच्चे मान से माध्य घटाएँ। कुछ नकारात्मक होंगे.
प्रत्येक अंतर को अपने आप से गुणा करें। सभी मान सकारात्मक होने चाहिए.
वर्गांकित अंतरों का योग करें। यह आपके वर्गों का योग है.
से विभाजित करें यह अंतिम चरण आपको भिन्नता प्रदान करता है।
जब डेटा सेट में समूह का प्रत्येक सदस्य शामिल हो, तो जनसंख्या विचरण का उपयोग करें - n से विभाजित करें, n - 1 से नहीं।
जनसंख्या भिन्नता तब लागू होती है जब आपके डेटा सेट में संपूर्ण जनसंख्या का प्रत्येक अवलोकन शामिल होता है - कोई नमूना नहीं। उदाहरण: एक कंपनी में सभी कर्मचारी, एक कक्षा में प्रत्येक परीक्षण स्कोर, गुणवत्ता नियंत्रण के दौरान एक बैच में सभी उत्पाद। सूत्र μ (सच्चा जनसंख्या माध्य) का उपयोग करता है और n (पूर्ण गणना) से विभाजित करता है। कोई बेसेल सुधार नहीं. स्वतंत्रता समायोजन की कोई डिग्री नहीं.
इंटरैक्टिव: नमूना आकार भिन्नता को कैसे प्रभावित करता है
यह देखने के लिए स्लाइडर को खींचें कि जनसंख्या आकार के साथ σ² और s² के बीच का अंतर कैसे बदलता है। छोटे n पर, अंतर बड़ा है। जैसे-जैसे n बढ़ता है, नमूना विचरण जनसंख्या विचरण की ओर परिवर्तित हो जाता है।
अभिसरण: जैसे-जैसे n बढ़ता है s² σ² के करीब पहुंचता है
9 विशिष्ट सांख्यिकीय कैलकुलेटर - प्रत्येक व्यक्तिगत चरण-दर-चरण समाधान, सूत्र और अक्सर पूछे जाने वाले प्रश्न के साथ। वह उपकरण चुनें जो आपकी समस्या के अनुकूल हो।
मानक विचलन कैलकुलेटर
चरण-दर-चरण समाधानों के साथ तुरंत मानक विचलन की गणना करें। अपना डेटा सेट दर्ज करें और जनसंख्या एसडी (σ), नमूना एसडी (एस),…
अर्थ कैलकुलेटर
किसी भी डेटा सेट के माध्य (औसत) की तुरंत गणना करें। विचरण, मानक विचलन, माध्यिका और बहुत कुछ के साथ अंकगणितीय माध्य प्राप…
नमूना भिन्नता कैलकुलेटर
चरण-दर-चरण समाधानों के साथ तुरंत नमूना विचरण (s²) की गणना करें। निष्पक्ष अनुमान के लिए बेसेल के सुधार (n−1) का उपयोग करत…
जनसंख्या भिन्नता कैलकुलेटर
चरण-दर-चरण समाधानों के साथ तुरंत जनसंख्या भिन्नता (σ²) की गणना करें। जब आपके पास पूरी आबादी हो तो सटीक भिन्नता के लिए एन…
भिन्नता का गुणांक कैलकुलेटर
भिन्नता के गुणांक (सीवी) की तुरंत गणना करें। विभिन्न इकाइयों या पैमानों के साथ डेटा सेटों में सापेक्ष परिवर्तनशीलता की त…
प्रतिशत भिन्नता कैलकुलेटर
मानों के बीच प्रतिशत भिन्नता की गणना करें या भिन्नता को माध्य के प्रतिशत के रूप में व्यक्त करें। भिन्नता, भिन्नता, मानक …
एकत्रित विचरण कैलकुलेटर
एकाधिक समूहों या नमूनों से एकत्रित विचरण की गणना करें। दो-नमूना टी-परीक्षण, एनोवा और मेटा-विश्लेषण के लिए नमूना भिन्नताओ…
पोकर वेरिएंस कैलकुलेटर
पोकर भिन्नता की गणना करें और किसी भी संख्या में हाथों से अपने अपेक्षित परिणामों को समझें। पोकर में जीत दर भिन्नता, डाउनस…
विचरण के बारे में वह सब कुछ जो आपको जानना आवश्यक है।
6, 7, 5, 9, 12, 15 के विचरण की गणना इस प्रकार की जाती है। माध्य = (6+7+5+9+12+15) / 6 = 9. माध्य से वर्ग विचलन: (6−9)²=9, (7−9)²=4, (5−9)²=16, (9−9)²=0, (12−9)²=9, (15−9)²=36. वर्गों का योग = 74. जनसंख्या विचरण (σ²) = 74 / 6 ≈ 12.33. नमूना विचरण (s²) = 74 / 5 = 14.8. यदि ये 6 संख्याएँ संपूर्ण डेटा सेट हैं तो जनसंख्या विचरण का उपयोग करें। यदि वे किसी बड़े समूह से लिए गए नमूना डेटा का प्रतिनिधित्व करते हैं तो नमूना विचरण का उपयोग करें।
1, 2, 3, 4, 5 के विचरण की गणना करने के लिए: माध्य = (1+2+3+4+5) / 5 = 3. माध्य से विचलन: −2, −1, 0, 1, 2. वर्ग विचलन: 4, 1, 0, 1, 4. वर्गों का योग = 10. जनसंख्या विचरण = 10 / 5 = 2. नमूना विचरण = 10 / 4 = 2.5. मानक विचलन √2 ≈ 1.414 (जनसंख्या) या √2.5 ≈ 1.581 (नमूना) है। इस डेटा सेट में कम विचरण है क्योंकि मान समान रूप से दूरी पर हैं।
एक्सेल में विचरण की गणना करने के लिए, नमूना विचरण के लिए VAR.S(range) और जनसंख्या विचरण के लिए VAR.P(range) का उपयोग करें। उदाहरण: =VAR.S(A1:A10) सेल A1 से A10 के लिए नमूना विचरण देता है। गूगल शीट्स भी इसी फ़ंक्शन का उपयोग करता है। पायथन में NumPy के साथ, नमूना विचरण के लिए np.var(data, ddof=1) का उपयोग करें।
प्रसरण, मानक विचलन और व्यावहारिक उदाहरणों पर हमारे शीर्ष ट्यूटोरियल देखें।
Statistics How to calculate variance step by step: find the mean, the deviations, the squared deviations and the sum of squares, with a fully worked example.
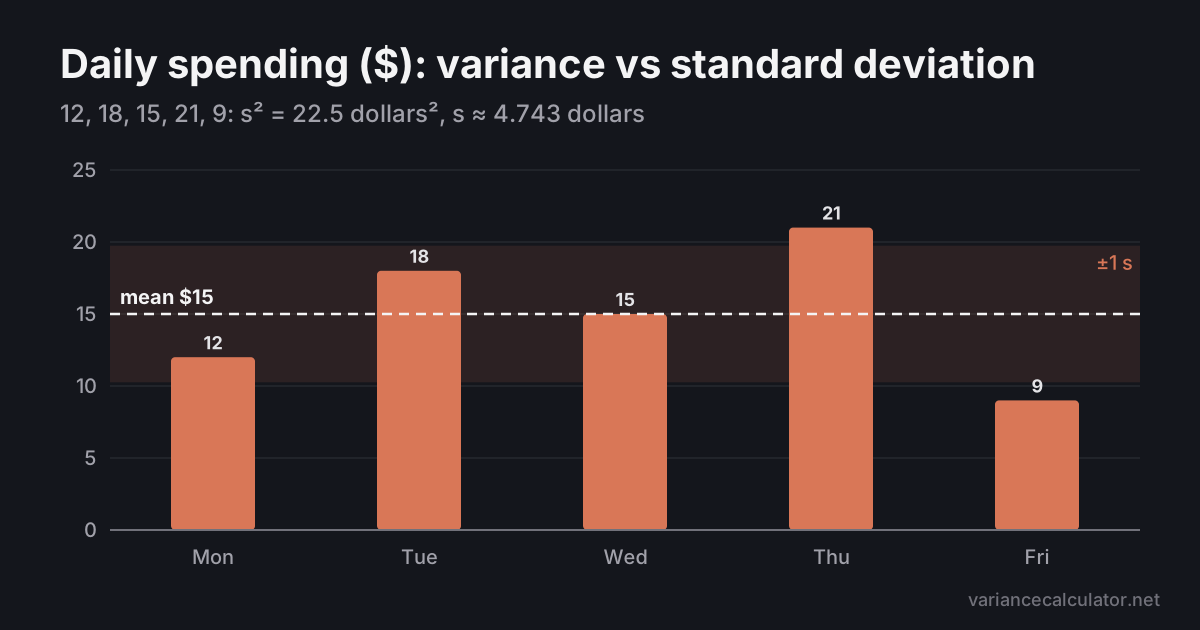 Statistics
Variance and standard deviation describe the same spread on different scales. How they connect, what their units mean, which to report, and a worked example.
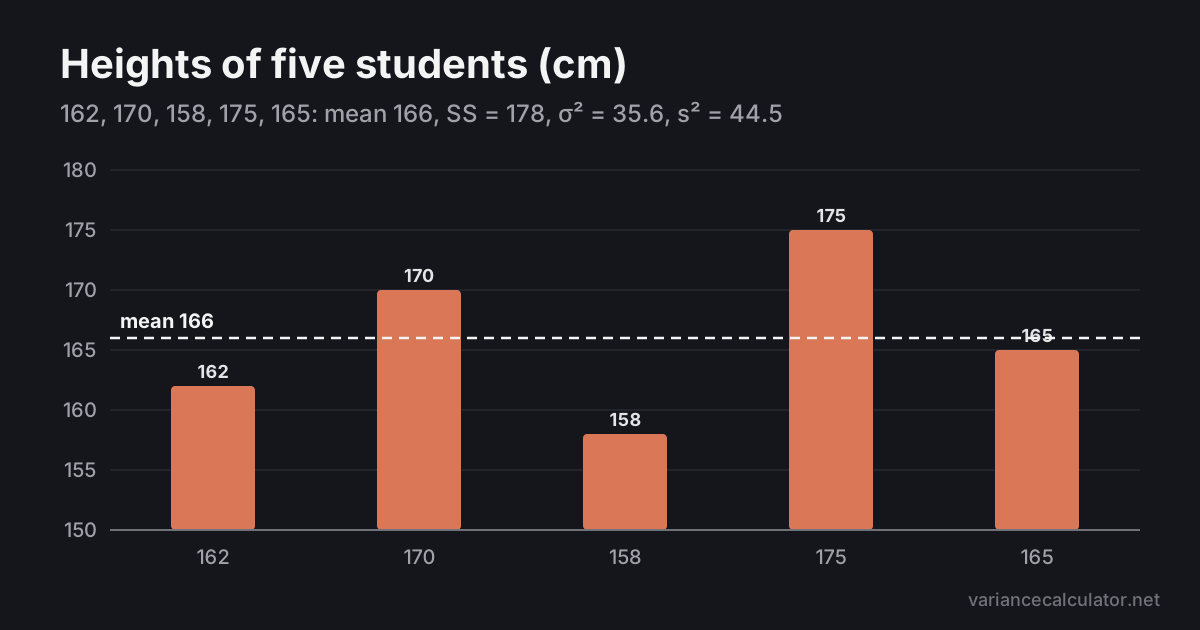 Statistics
When to use sample variance and when to use population variance, why dividing by n − 1 corrects a bias, and a worked example with both formulas.